Jevは、TypeSafe AIが開発した、ソフトウェアの中で判断を行うためのAIモデルです。長い回答文を読む使い方より、問い合わせの分類、項目の採点、条件に当てはまる確率の判定などをコードへ組み込む使い方を想定しています。
2026年9月15日に発表されたSystem One Modelsの最初の公開モデルで、発表時点では早期アクセスとして案内されています。この記事は9月18日に公式発表と開発者ドキュメントを確認した解説です。JevのAPIを使った速度・精度の実測レビューではありません。TypeSafe AIの発表記事
Jevとは?文章ではなく、処理に使う判断を返すモデル
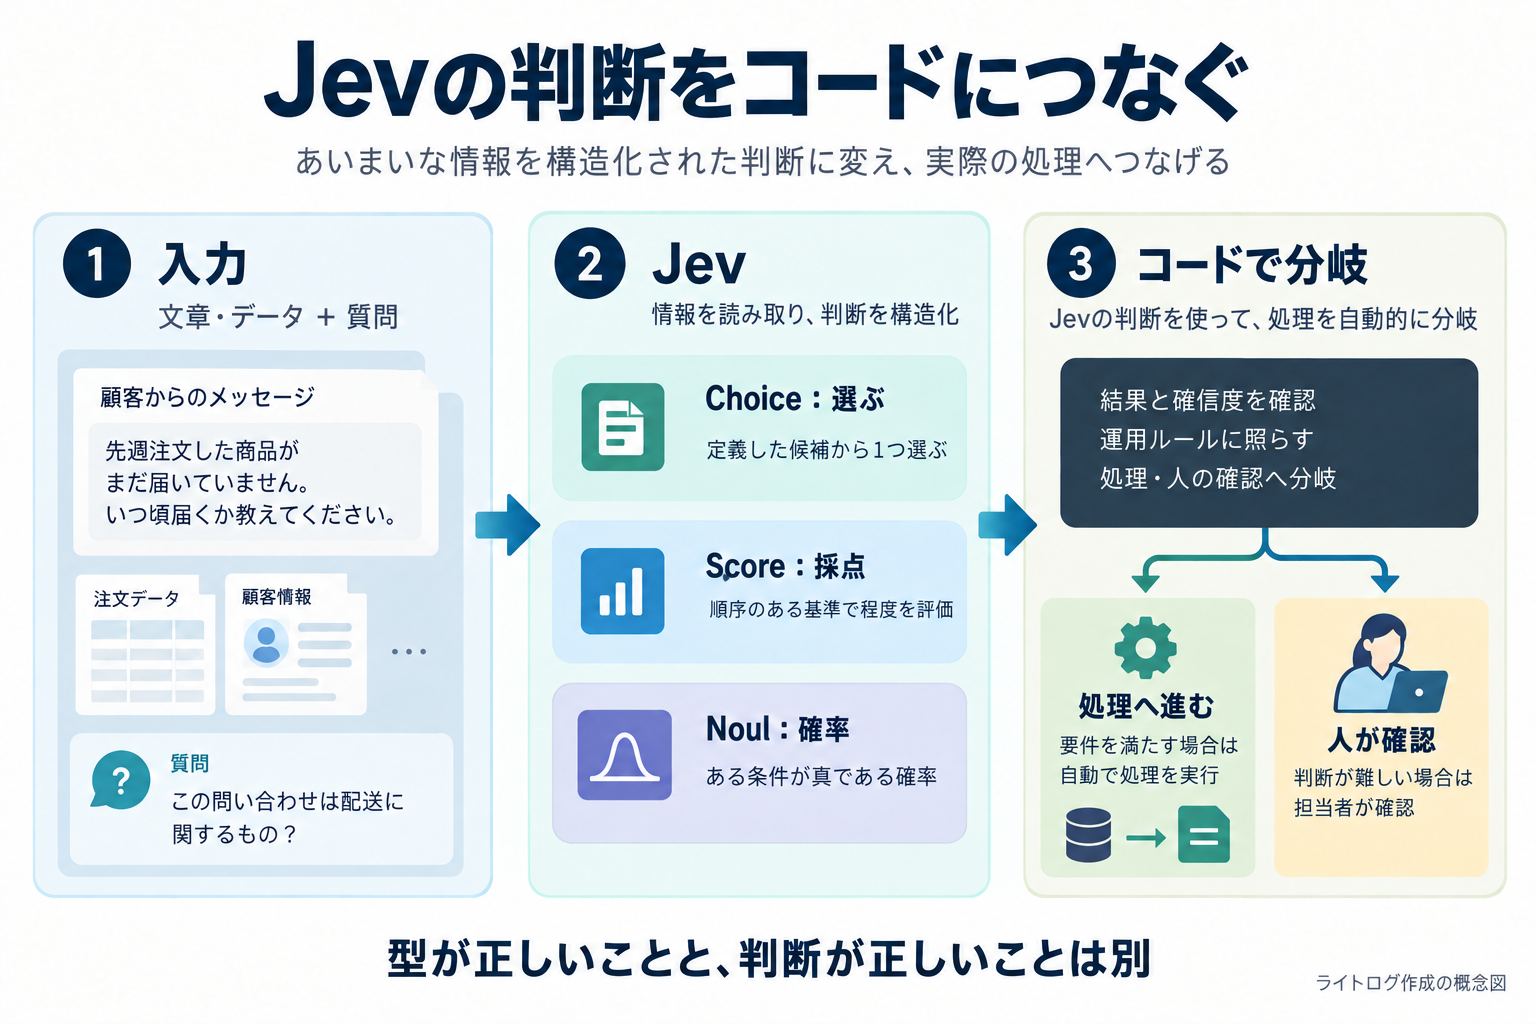
Jevには、判断の材料となる文章やデータであるstateと、何を判定するかを定義するquestionsを渡します。返ってくるのは、あらかじめ指定した型に沿った値です。例えば「請求・配送・その他のどこへ回すか」という選択を、アプリ側の振り分け処理に使えます。
TypeSafeは、このような速く限定された判断向けのモデル群をSystem One Modelsと呼んでいます。公式ドキュメントは、複雑な仕事を1つの大きな質問にせず、小さな判断へ分解してコードで組み合わせる構成を勧めています。公式ドキュメント:Introduction
Choice・Score・Noulの違い
基本となる質問は3種類です。返答が「分類先」なのか「程度」なのか「ある条件が真か」で使い分けます。
| 種類 | 何を返すか | ライトログ作成の質問例 |
|---|---|---|
| Choice | 定義した候補からの選択、候補ごとの確率、確信度 | 問い合わせの主題は請求・配送・その他のどれか |
| Score | 順序を持つ評価基準上のスコア、各段階の確率、確信度など | 情報の充足度は、不足・一部あり・必要項目ありのどの程度か |
| Noul | 条件が真である確率を0〜1で返す | 本文に商品の未着が明示されているか |
Noulの0.5は「程度が中くらい」という採点ではなく、真と偽に同じ確率を置いている状態です。Scoreは順序のある基準に沿った評価で、段階の間の値も返せます。同じリクエスト内の質問は独立して評価されるため、質問Aの回答を材料に質問Bを判定したい場合は、コード側で結果を受けて次のリクエストを作ります。公式ドキュメント:Primitives
「ハルシネーションゼロ」は、判断ミスゼロという意味ではない
公式発表はJevの型安全性を強く打ち出しています。その根拠として説明されているのは、出力が定義済みの構造に一致する保証です。記事中の型エラー0%も、実験で誤りが一度も出なかったという数値ではなく、この設計上の保証に基づくと明記されています。公式発表のHallucination and Type-safety
ここから「問い合わせの意味を常に正しく理解する」とまでは言えません。例えば配送の相談を、形式としては有効な「請求」に分類した場合、型は正しくても業務上の判断は誤りです。候補自体に適切な答えがなければ、候補設計を直す必要もあります。これは型と判断内容を分けて考えるための例で、Jevで観測した不具合ではありません。
confidenceをそのまま正答率として読まない
ChoiceとScoreのconfidenceは、返された確率分布がどれほど1つの答えへ集中しているかを要約した0〜1の値です。Noulにはこの項目がありません。「confidenceが0.9だから、この1件が90%の確率で正解」と同じ意味で扱わず、自分のデータで値と実際の正誤の関係を確認します。
公式も、処理を自動で進めるか、人の確認へ回すかの境界は用途と誤判断の影響に合わせて調整するよう案内しています。問い合わせの分類補助と、返金などの実行処理では、必要な確認を分ける設計が考えられます。公式ドキュメント:Confidence
速度・料金はどこまで確認できる?
TypeSafeのサイトには「193.6倍高速・444.6倍安価」という比較が掲載されています。ただし、特定のSystem One向けワークフローに基づく提供元の評価です。あらゆるチャット、文章作成、複雑な推論で同じ差が出るという意味ではありません。TypeSafe AI公式サイト
公開評価は4つのワークフローを使い、他社の大規模モデルによる回答の平均を参照ラベルにしています。人が全件の正解を確定した業務データとの比較とは区別して読む必要があります。自社の日本語問い合わせでの正確さや、利用地域からの待ち時間は、別途評価する項目です。公式Workflow evals
発表記事のAPI料金は入力100万トークンあたり0.042米ドル、出力トークンは無料です。単純計算では入力1,000万トークンで0.42米ドル、10億トークンで42米ドルとなります。これは公開単価による入力料金の計算例で、運用システム全体の費用や日本円での請求額ではありません。契約前には適用料金と利用条件を確認してください。発表記事の料金表
Jevの始め方:まずPlaygroundで質問を絞る
- 利用可能な状態か確認する。公式サイトにはWaitlistへの案内があります。早期アクセスの提供状況を確認します。
- Playgroundへログインする。試験用の文章をstateとして入れ、まず1つの条件をNoulで尋ねます。
- 必要に応じてChoiceやScoreを追加する。曖昧な質問は、候補や基準を定義して分けます。
- APIへ組み込む。公式のQuick startでは、ダッシュボードでAPIキーを取得し、
POST https://api.typesafe.ai/v1/systemoneを呼び出す流れを案内しています。
以下は公式のリクエスト形式に沿った未実行の作成例です。APIへ渡す入力だけを示し、応答値は掲載していません。実際のAPI呼び出しには認証と利用権限が必要です。公式Quick startとPlaygroundへの案内
{
  "model": "jev-latest",
  "state": "注文した商品が届いていません。配送状況を知りたいです。",
  "questions": {
    "delivery_issue": {
      "type": "noul",
      "instructions": "本文は注文した商品の未着を明示していますか?"
    }
  }
}
ライトログなら、記事公開前の確認補助から試す
サイト運営へ取り入れるなら、最初から記事の執筆・公開を一任するより、確認担当へ回す記事の選別を候補にします。次は当サイトへの導入実績ではなく、評価用の案です。
- コードで確認:本文画像の有無、出典リンクの有無、確認日の記録など、機械的に数えられる条件。
- Jevで評価する候補:本文が紹介・手順・比較のどれに当たるか、根拠なしに効果を断定する表現があるか。
- 人が判断:引用元が本当に主張を裏付けるか、画像が内容に合うか、公開してよい品質か。
例えば「出典リンクがある」だけで本文が正しいとは分かりません。Jevへ資料を渡して評価する場合も、その資料の新しさや必要情報の不足を確認します。文章生成が必要な工程と、候補や条件を判定する工程を分けると、試す範囲を明確にできます。
導入判断のために残す記録
正解を決めた試験用データで、通常例だけでなく、情報不足・複数の用件・分類候補にない文章を試します。次の記録から、実運用に使うか判断してください。
対象業務:
試験データの件数と選び方:
人が決めた正解・確認者:
質問・候補・採点基準:
モデル名と実行日:
返された値・確率・確信度:
誤判断の種類と影響:
実測の待ち時間・使用量・料金:
人の確認へ回す条件:
本番投入の可否と理由:
Jevの注目点は、判断の結果と不確実さを、アプリの分岐へ組み込みやすくしていることです。まずは用途を1つに絞り、型が合うことに加えて、判断の質と確認にかかる手間を確かめるのがよい出発点になります。
コメント